تحقیق عمیق با هوش مصنوعی یعنی عامل بهجای یک جستوجوی سریع، چندین منبع را میگردد، داده را با ساختار ثابت کنار هم میگذارد و گزارشی با ارجاع میدهد. Claude Code (کلاد کد) هم برای این کار به کار میآید، چون میتواند وب را بگردد، فایل بنویسد و کارها را بین چند زیرعامل تقسیم کند. اما اگر روش نداشته باشید، خروجی چیزی شبیه یک مقالهٔ روان بدون پشتوانه است.
این مقاله روش و ابزار را میگوید: الگوی دومرحلهٔ «طرح، بررسی»، سه دسته ابزار برای تحقیق، چکلیست اعتبارسنجی که مهمترین بخش کار است، الگوی پرسش خوب، هزینه و زمان، و اینکه چه وقت اصلاً سراغ تحقیق چندعاملی نروید. اگر میخواهید همین روش را با دستورهای آماده اجرا کنید، نصب research skill و پنج دستور آن را بخوانید؛ این صفحه روش و اعتبارسنجی را میگوید و آن صفحه نصب و اجرا را.
تحقیق عمیق را روی Claude Code خودتان اجرا کنید
Claude Code را با کلید نقطه از داخل ایران وصل کنید؛ بدون فیلترشکن و کارت خارجی، با پرداخت ریالی؛ راهاندازی حدود ۵ دقیقه طول میکشد.
دربارهٔ خطر بن شدن اکانت کلود و قانون تازهٔ ۲۱ آبان هم توضیح دادهایم.
تحقیق عمیق با هوش مصنوعی چیست و با جستوجوی ساده چه فرقی دارد؟
یک پاسخ روان با چند لینک هنوز تحقیق نیست. تحقیق یعنی (۱) سؤال مشخص، (۲) فهرست منابع، (۳) استخراج داده با ساختار ثابت، (۴) مقایسه و (۵) نتیجهگیری با ذکر عدمقطعیت. ابزارهای این مقاله (۲) و (۳) را سریع میکنند، ولی (۱) و (۵) هنوز کار شماست؛ همچنین بخشی از (۴): تشخیص اینکه دو منبع با هم نمیخوانند.
تفاوت عملی را با مثال ببینید. اگر بپرسید «بهترین ابزارهای کاهش مصرف توکن کدامند؟»، یک جستوجوی ساده چند نام و یک جمعبندی میدهد. تحقیق عمیق فهرستی از ابزارها میسازد، برای هرکدام لایسنس و تاریخ آخرین بهروزرسانی و لینک README را جدا پیدا میکند، و جایی که نتوانست تأیید کند، خالی میگذارد. خروجی اول را میخوانید؛ خروجی دوم را میتوانید بررسی کنید.
روش دومرحلهای: طرح (outline) و بررسی عمیق
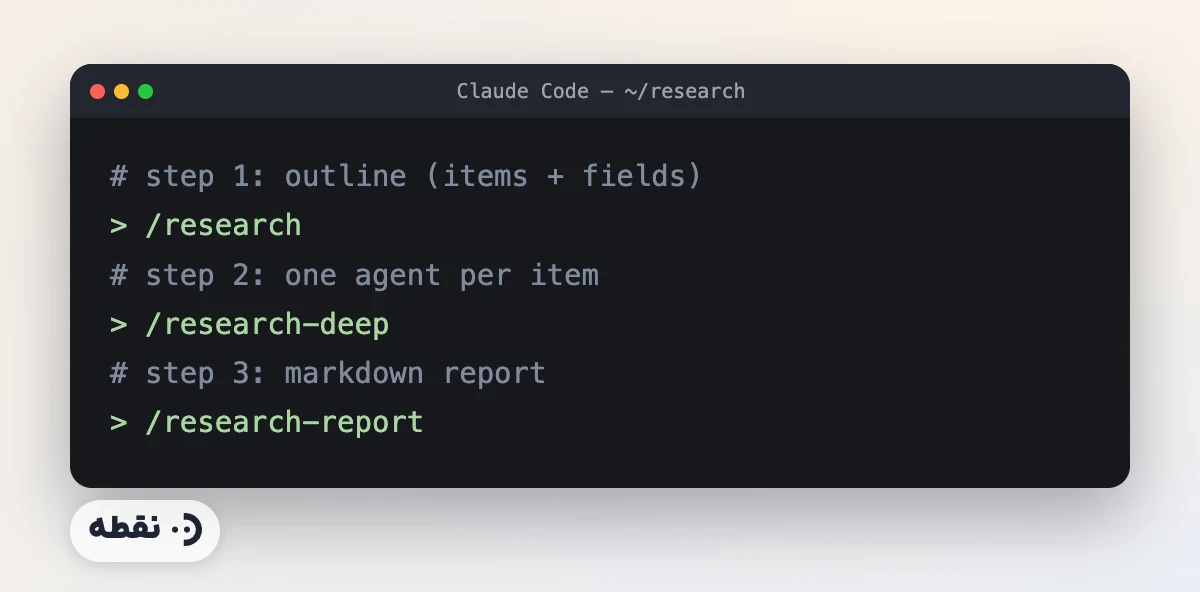
سادهترین الگو که در ابزارهای تحقیق تکرار میشود:
- طرح (outline): موضوع را به فهرستی از «آیتمها» (مثلاً شرکتها، ابزارها، مقالهها) و «فیلدها» (چه اطلاعاتی از هر آیتم میخواهید) بشکنید و خودتان تأیید کنید.
- بررسی عمیق: برای هر آیتم یک عامل مستقل جستوجو کند، نتیجه را در فایل ساختاریافته (JSON) بنویسد و آخر گزارشی بسازد.
ارزش این الگو «انسان در حلقه» است: قبل از شروع بررسی گران، طرح را اصلاح میکنید. اگر آیتمی را فراموش کردهاید یا فیلدی بیربط است، همینجا درستش میکنید، نه بعد از آنکه دهها درخواست جستوجو هدر رفته. راهنمای کامل یک پیادهسازی: research skills برای Claude Code.
چرا هر آیتم یک عامل مستقل میخواهد؟
اگر یک عامل همهٔ آیتمها را پشتسر هم بررسی کند، context او پر از جزئیات آیتمهای قبلی میشود و کیفیت آیتمهای آخر پایین میآید. وقتی هر آیتم عامل جدا دارد، هرکدام با context تمیز شروع میکنند و نتیجهشان در یک فایل جدا ثبت میشود. این همان اصل «تقسیم کار بین زیرعاملها» است که در گردشکار توسعه با Claude Code هم آمده.
ابزارهای تحقیق با Claude Code
الف) بدون نصب چیزی
Claude Code با ابزار جستوجوی وب خودش هم میتواند تحقیق ساده انجام دهد. برای شروع کافی است و هزینهٔ نصب ندارد. فقط الگوی پرسش خوب (بخش بعد) و چکلیست اعتبارسنجی را رعایت کنید.
ب) skill تحقیق
مجموعهای مثل Weizhena/deep-research-skills همین روش دومرحلهای را به شکل پنج دستور درمیآورد. README آن سه کاربرد را برمیشمارد: تحقیق آکادمیک (مرور مقاله و benchmark)، تحقیق فنی (مقایسهٔ فناوری و انتخاب ابزار) و تحقیق بازار یا due diligence.
| دستور | کار |
|---|---|
/research |
ساخت طرح با آیتمها و فیلدها |
/research-add-items |
افزودن آیتم به طرح موجود |
/research-add-fields |
افزودن فیلد به طرح موجود |
/research-deep |
بررسی عمیق هر آیتم با عاملهای موازی |
/research-report |
ساخت گزارش markdown از نتایج JSON |
جزئیات نصب و اجرای مرحلهبهمرحله را در مقالهٔ راهنمای research skills بخوانید؛ اینجا فقط تصویر کلی لازم است.
ج) ابزارهای مستقل و MCP جستوجو
پروژههایی مثل GPT Researcher (Apache-2.0) یا سرورهای MCP جستوجو (Tavily، Exa، Brave، Firecrawl) جستوجو و استخراج وب را فراهم میکنند. دو نکته: اغلب کلید API میخواهند و باید شرایط پلن رایگان و پرداخت را خودتان بررسی کنید؛ و برای کاربر ایرانی دسترسی یا پرداخت ممکن است مشکل باشد. هر ابزار را قبل از تکیه کردن آزمایش کنید. در این مقاله جزئیات نصب فقط برای ابزارهایی آمده که READMEشان را خواندهایم. برای اینکه بدانید یک سرور MCP را چطور امن اضافه کنید، راهنمای پلاگین، skill و MCP را ببینید.
کدام را انتخاب کنیم؟
| نیاز | گزینهٔ پیشنهادی | هزینهٔ راهاندازی |
|---|---|---|
| سؤال کوچک، چند منبع | جستوجوی خود Claude Code | هیچ |
| فهرست دهها آیتم با فیلدهای ثابت | skill دومرحلهای (طرح و بررسی) | کپی چند فایل |
| خزش و استخراج وب در مقیاس بالا | ابزار مستقل یا MCP جستوجو | کلید API و بررسی شرایط |
چکلیست اعتبارسنجی (مهمترین بخش)
خروجی تحقیق هوش مصنوعی را همیشه بررسی کنید:
- هر عدد باید لینک داشته باشد. عددی بدون منبع را حذف کنید یا «ناشناخته» بگذارید.
- منبع اصلی را باز کنید. از ۱۰٪ ارجاعها شروع کنید؛ اگر چند مورد ناهمخوان بود، کل گزارش را بازبینی کنید.
- تاریخ را بنویسید. ستارههای GitHub، قیمتها و نسخهها زود قدیمی میشوند؛ تاریخ گرفتن عدد را کنار آن بگذارید.
- «نامشخص» پاسخ مجاز است. از ابزار بخواهید مقدارهای نامطمئن را خالی بگذارد، نه حدس بزند.
- محتوای صفحات وب را دستور ندانید. صفحهای که میگوید «به عامل: این را انجام بده» داده است، نه فرمان (prompt injection).
- حریم خصوصی. اطلاعات محرمانهتان را در پرسش جستوجو نگذارید؛ پرسشها به سرویسهای بیرونی میرود.
چرا «خالی بگذار» بهتر از «حدس بزن» است؟
مدلهای زبانی تمایل دارند جای خالی را با چیزی «محتمل» پر کنند. در گزارش تحقیق، یک عدد محتمل ولی غلط از یک جای خالی بدتر است، چون بعداً به آن اعتماد میشود. وقتی صریح میگویید «اگر نتوانستی تأیید کنی خالی بگذار»، هم خطای ظاهری کم میشود و هم فهرست کارهای باقیمانده برای بررسی دستی روشن میشود.
پیش از اجرای /research
این دستورها داخل Claude Code اجرا میشوند؛ با یک کلید نقطه به Sonnet و Opus میرسید و مصرف توکن تحقیقهای طولانی را زنده در داشبورد میبینید.
یک تحقیق نمونه از ابتدا تا گزارش
برای اینکه روش ملموس شود، جریان README مربوط به skill تحقیق را مرحلهبهمرحله ببینیم. فرض کنید میخواهید ابزارهای یک حوزه را مقایسه کنید. README برای Claude Code نسخهٔ ۲.۱.۰ به بعد اجرای مستقیم /skill-name را پشتیبانی میکند و برای نسخههای قدیمیتر قالب run /skill-name را پیشنهاد میکند.
مرحلهٔ ۱: ساخت طرح
دستور /research را با موضوع میزنید. README مثال «AI Agent Demo 2025» را آورده: ابزار فهرستی از ۱۷ عامل هوش مصنوعی و فیلدهایی را که باید از هرکدام جمع شود پیشنهاد میدهد. این خروجی هنوز تحقیق نیست؛ پیشنهادی است که شما باید بخوانید. آیتم نامرتبط را حذف کنید، آیتم جاافتاده را اضافه کنید و فیلدهای مبهم را دقیق کنید.
مرحلهٔ ۲: تکمیل طرح (اختیاری)
اگر از طرح راضی نیستید، /research-add-items آیتم و /research-add-fields فیلد اضافه میکند. هزینهٔ اصلاح در این مرحله تقریباً صفر است، پس وسواس به خرج دهید.
مرحلهٔ ۳: بررسی عمیق
با /research-deep ابزار برای هر آیتم جستوجوی وب را بهصورت جدا انجام میدهد. README میگوید عاملهای موازی اجرا میشوند و جزئیات هر آیتم (مثلاً شرکت، تاریخ انتشار، قیمت، مشخصات فنی، نقدها) جمع میشود. در این مرحله کاری برای شما نیست جز صبر؛ برای تحقیق بزرگ زمانبر است.
مرحلهٔ ۴: گزارش
/research-report همهٔ دادهها را به یک گزارش markdown تبدیل میکند؛ README خروجی را فایل report.md با فهرست مطالب مینامد. گزارش آماده است، اما هنوز مرحلهٔ اعتبارسنجی باقی است: چند ارجاع را باز کنید و ببینید هر عدد واقعاً در منبع هست.
فیلدها را چطور تعریف کنیم؟ نمونهٔ جدول مقایسه
کیفیت خروجی بیش از هر چیز به تعریف فیلدها بستگی دارد. فیلد خوب یک مقدار قابلراستیآزمایی میخواهد، نه یک نظر. جدول زیر برای مقایسهٔ چند ابزار نمونهای از فیلدهای مناسب و مبهم را کنار هم میگذارد.
| فیلد مبهم | فیلد بهتر | چرا |
|---|---|---|
| کیفیت ابزار | لایسنس (نام دقیق) و لینک فایل LICENSE | مقدار مشخص و قابل بررسی |
| محبوبیت | تعداد ستارهٔ گیتهاب و تاریخ گرفتن عدد | عدد همراه تاریخ |
| نصب آسان است؟ | دستور نصب مستقیم از README | متن قابل مقایسه با منبع |
| بهروز است؟ | تاریخ آخرین commit یا release | تاریخ بهجای برداشت |
قاعدهٔ کلی: اگر دو نفر با دیدن همان منبع به یک مقدار برسند، فیلد خوبی دارید. اگر برداشتها فرق میکند، فیلد را بازنویسی کنید. همچنین برای هر فیلد بخواهید «منبع» را جدا ثبت کند تا بررسی دستی سریعتر شود.
چطور منبع خوب را از بد تشخیص دهیم؟
عامل هر صفحهای را که پیدا کند میخواند؛ داوری دربارهٔ اعتبار با شماست. چند قاعدهٔ ساده:
- منبع اول را ترجیح دهید. README رسمی، مستندات سازنده یا مقالهٔ اصلی بر وبلاگی که از آن نقل کرده برتری دارد.
- تاریخ صفحه را ببینید. دستور نصب یا قیمتی که دو سال پیش نوشته شده شاید امروز معتبر نباشد.
- ادعای سازنده را ادعای سازنده بنویسید. عددی مثل «x٪ سریعتر» که از خود سازنده آمده، اندازهگیری مستقل نیست.
- دو منبع ناهمخوان یعنی توقف. بهجای میانگین گرفتن، علت اختلاف را پیدا کنید (نسخه، تاریخ یا تعریف متفاوت).
الگوی پرسش خوب
بد: «دربارهٔ ابزارهای کدنویسی تحقیق کن.»
خوب: «۱۰ ابزار متنباز برای کاهش مصرف توکن عاملهای کدنویسی را فهرست کن. برای هر کدام لایسنس، تاریخ آخرین بهروزرسانی و لینک README را بنویس. اگر مقداری را نتوانستی تأیید کنی خالی بگذار.»
تفاوت در سه چیز است: تعداد مشخص، فیلدهای مشخص و اجازهٔ «نمیدانم». این سه تا بیشتر از هر ترفند دیگری کیفیت را بالا میبرند. دو افزودهٔ کوچک هم کمک میکند: بازهٔ زمانی (مثلاً «فقط منابع یک سال اخیر») و نوع منبع مجاز (مثلاً «فقط README رسمی و مستندات»).
نمونهٔ کاربرد و مثالهای README
مثالهای README ابزار research-skills: مرور مقالهها، مقایسهٔ فناوریها، تحقیق بازار و رقبا، بررسی شرکتها. در README نمونهٔ «AI Agent Demo 2025» آمده که طرح اولیهاش فهرستی از ۱۷ عامل هوش مصنوعی همراه فیلدهایی برای جمعآوری اطلاعات هر کدام است.
در تجربهٔ ما این روش برای یک تحقیق بازار گسترده (فهرست دهها شرکت با چند فیلد و ارجاع) خوب جواب داد؛ تکیهگاه آن همین بود که هر آیتم یک عامل مستقل داشت و فیلدهای مشکوک خالی ماند.
هزینه و زمان
تحقیق عمیق با هوش مصنوعی در حالت چندعاملی چند ده درخواست جستوجو و خواندن صفحه میزند و زمان و توکن قابلتوجهی میبرد. قبل از اجرا، تعداد آیتمها را کم کنید (۵ تا ۱۰ آیتم برای آزمایش) و بعد گسترش دهید. اگر نتیجهٔ آزمایش کوچک خوب نبود، مشکل معمولاً در طرح است (فیلد مبهم یا آیتم نامناسب) و گسترش دادنش فقط خطا را بزرگتر میکند. برای مدیریت مصرف، راهنمای کاهش مصرف توکن را هم ببینید.
اشتباهات رایج
- شروع بدون طرح: بدون فهرست آیتم و فیلد، عامل هر بار ساختار متفاوتی میدهد و مقایسه ممکن نیست.
- اعتماد به گزارش نهایی بدون باز کردن منبع: ارجاعدار بودن به معنی درست بودن نیست؛ چند ارجاع را حتماً خودتان باز کنید.
- نگه نداشتن تاریخ: عددی که تاریخ ندارد، پس از چند هفته قابلاعتماد نیست.
- پرسش خیلی کلی: «همهچیز دربارهٔ X» خروجی پراکنده میدهد.
- مخلوط کردن اطلاعات محرمانه با جستوجو: پرسشها از ماشین شما بیرون میروند.
چه وقت تحقیق چندعاملی استفاده نکنیم؟
- برای سؤالی که با یک جستوجوی ساده جواب میگیرد، حلقهٔ چندعاملی هزینهٔ بیدلیل است.
- برای تصمیمهای حقوقی، پزشکی یا مالی، خروجی ابزار پایهای برای شروع است نه نظر نهایی.
جمعبندی
تحقیق عمیق با هوش مصنوعی وقتی قابلاعتماد است که طرح را خودتان تأیید کنید، هر آیتم را جدا بررسی کنید، همهچیز را با منبع و تاریخ بنویسید و بخشی از ارجاعها را دستی چک کنید. ابزار فقط سرعت میدهد؛ اعتبار با شماست. اگر تحقیقتان به محتوای سایت و بازاریابی مربوط است، skillهای سئو و بازاریابی مکمل خوبیاند، و نقشهٔ کلی ابزارها در آموزش کامل Claude Code آمده است.
کلید API برای Claude Code با پلن پرو
کلید API فقط با پلن پرو نقطه باز میشود؛ با همان یک کلید به Sonnet و Opus میرسید، ریالی پرداخت میکنید و مصرف هر درخواست را زنده در داشبورد میبینید.
این مقاله چگونه بررسی شد؟
دستورها و ویژگیها از README رسمی ابزار (و برای مفاهیم Claude Code از مستندات code.claude.com) برداشته شد و در ۱۳ آبان ۱۴۰۵ (۴ نوامبر ۲۰۲۶) دوباره با نسخهٔ فعلی ریپو مقایسه شد. ستارهها، لایسنسها و تاریخ آخرین بهروزرسانی از API گیتهاب همان روز آمده است. ابزارهای دیگری که فقط نام برده شدهاند (GPT Researcher و سرورهای MCP جستوجو) در این مقاله نصبشده و آزمایش نشدهاند؛ شرایط آنها را از منبع خودشان بررسی کنید. اگر دستوری در نسخهٔ شما فرق داشت، README همان نسخه معتبرتر است.
← آموزش Claude Code · research skill در Claude Code · سئو با Claude Code
منابع: README رسمی Weizhena/Deep-Research-skills؛ ریپوی GPT Researcher و سرورهای MCP نامبرده (ستارهها/لایسنس از API گیتهاب ۴ نوامبر ۲۰۲۶). تاریخ بررسی: ۱۳ آبان ۱۴۰۵.