research skill Claude Code مجموعهای از پنج دستور آماده برای Claude Code (کلاد کد) است که یک تحقیق بزرگ را به دو مرحله میشکند: اول یک «طرح تحقیق» میسازید که میگوید دقیقاً چه چیزهایی را بررسی کنیم و از هرکدام چه اطلاعاتی بگیریم، بعد هر مورد با یک عامل جداگانه عمیق بررسی میشود و در پایان یک گزارش Markdown میگیرید. مجموعهٔ مورد بحث ریپوی متنباز Weizhena/Deep-Research-skills است و راهنمای حاضر بر پایهٔ README رسمی آن نوشته شده.
در این مقاله میخوانید این ابزار دقیقاً چه میکند، چطور آن را برای Claude Code نصب کنید، پنج دستور چه فرقی با هم دارند، طرح تحقیق خوب چه شکلی است، گزارش نهایی را چطور اعتبارسنجی کنید و چه محدودیتهایی دارد. اگر هنوز تصویر کلی تحقیق عمیق با هوش مصنوعی را نخواندهاید، اول راهنمای تحقیق عمیق با Claude Code را ببینید و بعد به همینجا برگردید.
research skill را روی Claude Code خودتان اجرا کنید
Claude Code را با کلید نقطه از داخل ایران وصل کنید؛ بدون فیلترشکن و کارت خارجی، با پرداخت ریالی؛ راهاندازی حدود ۵ دقیقه طول میکشد.
اگر برایتان سؤال است چرا اکانت کلود بن میشود، این راهنما خبر ۲۱ آبان و راهحل را با منبع آورده است.
ستارهٔ ریپو در ۴ نوامبر ۲۰۲۶: حدود ۲٫۵ هزار؛ لایسنس MIT. این ابزار کوچک است؛ پیش از تکیه کردن، کدش را بخوانید.
research skill Claude Code چیست؟
«Skill» در Claude Code یک بستهٔ دستورالعمل است که به شکل پوشهای با فایل SKILL.md در ~/.claude/skills قرار میگیرد و Claude آن را وقتی لازم باشد میخواند یا شما مستقیم با یک دستور اسلش صدایش میزنید. جزئیات این سازوکار در مستندات رسمی skillها آمده و در راهنمای پلاگین، skill و MCP هم خلاصهاش را نوشتهایم.
مجموعهٔ Deep-Research-skills پنج skill از این نوع است که با هم یک خط تولید تحقیق میسازند. README رسمی آن را «گردشکار تحقیق ساختاریافته» برای Claude Code، OpenCode و Codex توصیف میکند و دو مرحله دارد: تولید طرح (که قابل گسترش است) و بررسی عمیق. تأکید README روی «انسان در حلقه» است؛ یعنی بین مرحلهها خودتان طرح را میخوانید، اصلاح میکنید و بعد اجازه میدهید بخش گران کار شروع شود.
README موارد استفاده را چهار دسته میداند:
- پژوهش دانشگاهی: مرور مقالهها، بررسی بنچمارکها و تحلیل پیشینه.
- تحقیق فنی: مقایسهٔ فناوریها، ارزیابی فریمورکها و انتخاب ابزار.
- تحقیق بازار: تحلیل رقبا، روند صنعت و مقایسهٔ محصولات.
- due diligence: بررسی شرکتها، تحلیل سرمایهگذاری و ارزیابی ریسک.
نکتهٔ مشترک همهٔ اینها یک چیز است: تعداد زیادی «مورد» دارید و برای هرکدام چند «ویژگی» میخواهید. اگر سؤال شما یک جواب کوتاه دارد، به این ابزار نیازی ندارید؛ یک پرسش ساده در خود Claude Code سریعتر و ارزانتر است.
چرا تحقیق دومرحلهای بهتر از یک پرامپت بزرگ است؟
وقتی از مدل میخواهید «دربارهٔ بیست شرکت این حوزه تحقیق کن»، همهچیز در یک گفتگوی طولانی اتفاق میافتد. زمینه (context) پر میشود، مدل از نیمههای کار شروع به خلاصهگویی میکند و شما تا پایان نمیفهمید کدام مورد را فراموش کرده یا چه چیزی را حدس زده است. جداکردن «چه چیزی را بررسی کنیم» از «بررسی خود آن» چند مزیت عملی دارد:
- اشتباه ارزانتر کشف میشود. اگر فهرست آیتمها یا فیلدها غلط باشد، پیش از اینکه توکن زیادی خرج شود میبینید.
- هر مورد زمینهٔ تمیز دارد. در مرحلهٔ بررسی عمیق، README میگوید هر آیتم با عامل موازی جدا بررسی میشود؛ پس اطلاعات یک آیتم با دیگری قاطی نمیشود.
- خروجی ساختار ثابت دارد. چون فیلدها از قبل مشخص شدهاند، نتیجه در قالب JSON جمع میشود و بعد به گزارش تبدیل میشود، نه یک متن آزاد.
- قابل ادامه است. میتوانید بعداً با
/research-add-itemsمورد تازه یا با/research-add-fieldsفیلد تازه اضافه کنید، بدون اینکه از اول شروع کنید.
منبع الهام این طراحی، به گفتهٔ README، مقالهای به نام RhinoInsight دربارهٔ کنترل رفتار مدل و context در تحقیق عمیق است. این یک ایدهٔ پژوهشی است، نه ضمانت کیفیت؛ کیفیت واقعی همچنان به موضوع، ابزار جستوجو و نظارت خودتان بستگی دارد.
نصب research skill برای Claude Code
نصب research skill Claude Code یعنی کپیکردن چند پوشه و نصب یک وابستگی پایتونی. پیش از هر کپی، ریپو را در یک پوشهٔ جدا کلون کنید و محتوای آن را بخوانید؛ این skillها به عامل شما دستور میدهند و بهتر است بدانید چه نوشتهاند.
git clone https://github.com/Weizhena/deep-research-skills.git
cd deep-research-skills
بعد، طبق بخش Claude Code در README:
# نسخهٔ انگلیسی (یا research-zh برای چینی)
cp -r skills/research-en/* ~/.claude/skills/
# لازم: عامل جستوجو و ماژولها
cp agents/web-search-agent.md ~/.claude/agents/
cp -r agents/web-search-modules ~/.claude/agents/
# لازم: وابستگی پایتون
pip install pyyaml
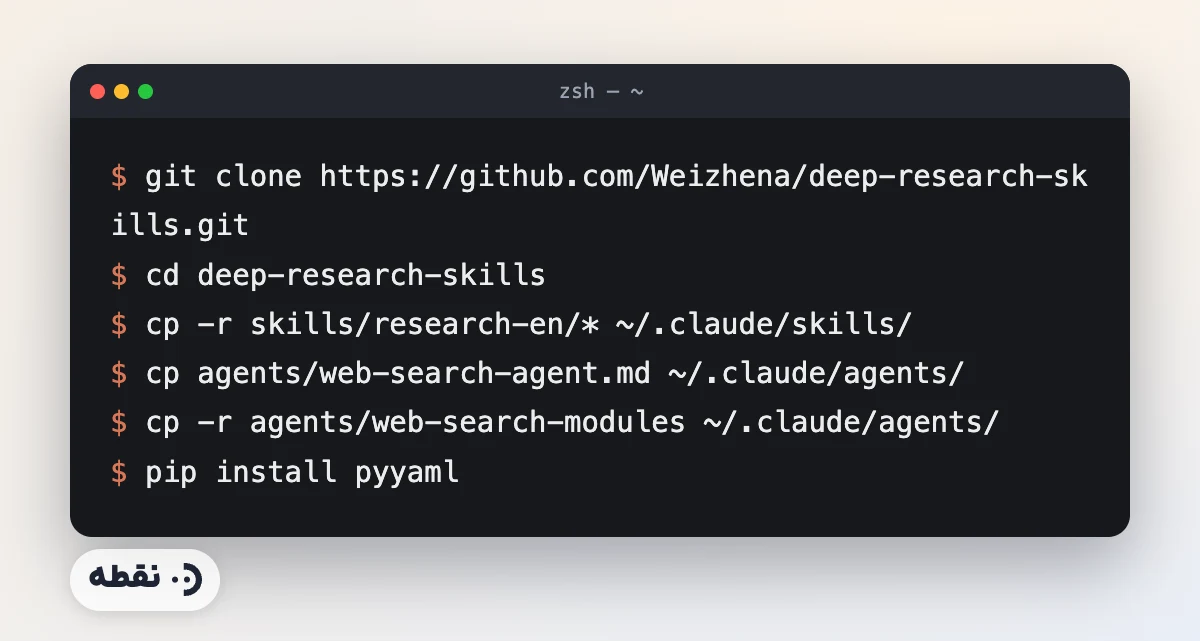
هر خط چه میکند؟ خط اول پنج skill را در پوشهٔ skillهای کاربر میگذارد تا در همهٔ پروژهها در دسترس باشند. خطهای بعد «عامل جستوجوی وب» و ماژولهایش را در ~/.claude/agents قرار میدهند؛ مرحلهٔ بررسی عمیق برای هر آیتم از همین عامل استفاده میکند. README هر دو را «لازم» میداند، پس از آنها نگذرید. وابستگی pyyaml هم برای کار با فایلهای YAML ابزار لازم است.
دو نکتهٔ زبان و نسخه:
- README فقط دو نسخهٔ انگلیسی و چینی دارد؛ نسخهٔ فارسی نیست. دستورالعملها انگلیسیاند، اما میتوانید موضوع و خواستهتان را فارسی بنویسید و زبان گزارش را در prompt مشخص کنید.
- نسخهٔ Claude Code ۲٫۱٫۰ یا بالاتر لازم است تا دستورها را مستقیم با
/نام-skillاجرا کنید؛ در نسخههای قدیمیتر باید به شکلrun /skill-nameبنویسید.
اگر هنوز Claude Code و ابزارهای کناریاش را نصب نکردهاید، راهنمای نصب ابزارهای Claude Code همهٔ مراحل را یکجا آورده است.
چه چیزی را کپی نکنید
اگر از قبل پوشهای با نام مشابه در ~/.claude/skills دارید، دستور cp -r آن را با فایلهای جدید ادغام یا بازنویسی میکند. قبل از کپی، با ls ~/.claude/skills ببینید چه دارید و در صورت لزوم نسخهٔ پشتیبان بگیرید. همچنین بهخاطر داشته باشید این دستورها روی کل حساب کاربری اثر میگذارند، نه یک پروژه؛ اگر فقط یک پروژه را میخواهید، مستندات Claude Code برای skillهای سطح پروژه پوشهٔ .claude/skills داخل همان پروژه را معرفی میکند.
قبل از اجرای اولین /research
skillها نصب شدند؛ حالا خود Claude Code باید به مدل وصل باشد. با یک کلید نقطه به Sonnet و Opus میرسید و مصرف توکن
/research-deepرا زنده در داشبورد میبینید.
پنج دستور research skill چه فرقی با هم دارند؟
| دستور | کار | کی سراغش بروید |
|---|---|---|
/research |
ساخت طرح: فهرست آیتمها و فیلدها | شروع هر تحقیق تازه |
/research-add-items |
افزودن آیتم به طرح موجود | فهرست ناقص است یا مورد تازهای پیدا شده |
/research-add-fields |
افزودن فیلد به طرح موجود | اطلاعات بیشتری از هر آیتم لازم دارید |
/research-deep |
بررسی عمیق هر آیتم با عاملهای موازی | بعد از اینکه طرح را تأیید کردید |
/research-report |
ساخت گزارش Markdown از نتایج JSON | بعد از پایان بررسی عمیق |
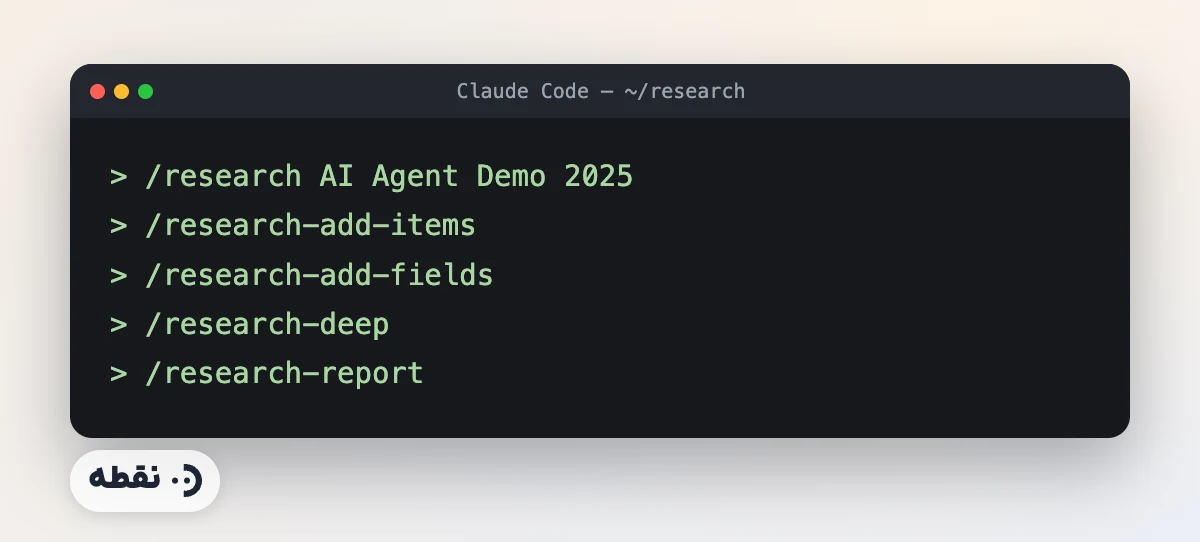
ترتیب طبیعی کار این است: /research یک بار، در صورت نیاز یک یا چند بار add-items و add-fields، بعد /research-deep و در آخر /research-report. تنها دستور پرهزینه /research-deep است؛ بقیه سبکاند.
مثال گامبهگام: از موضوع تا گزارش
مثالی که خود README میآورد موضوع «AI Agent Demo 2025» است. مراحل را با همان مثال دنبال میکنیم.
مرحلهٔ ۱: ساخت طرح
/research AI Agent Demo 2025
طبق README، در این مرحله موضوع را میگویید و فهرستی از مواردی که باید بررسی شود میگیرید. در مثال README این فهرست ۱۷ عامل هوش مصنوعی است و برای هرکدام فیلدهایی که باید جمع شود. هنوز چیزی گران اتفاق نیفتاده و فقط یک طرح دارید.
مرحلهٔ ۲ (اختیاری): گسترش طرح
/research-add-items
/research-add-fields
اگر آیتمی جا افتاده یا ستونی که میخواهید در طرح نیست، همینجا اضافه کنید. اینجا مهمترین لحظهٔ «انسان در حلقه» است: فهرست را با چشم خودتان بخوانید.
مرحلهٔ ۳: بررسی عمیق
/research-deep
README این مرحله را اینطور میگوید: هوش مصنوعی برای هر آیتم در وب جستوجو میکند. نتیجه برای هر مورد اطلاعات تفصیلی است (در مثال README: شرکت، تاریخ انتشار، قیمتگذاری، مشخصات فنی، نقدها و غیره).
مرحلهٔ ۴: گزارش
/research-report
خروجی طبق README فایل report.md است؛ گزارش Markdown کامل با فهرست مطالب، آمادهٔ خواندن یا اشتراکگذاری. مسیر دقیق ذخیره را هنگام اجرا در خروجی خود Claude Code ببینید.
طرح تحقیق خوب چه شکلی است؟
کیفیت گزارش نهایی بیشتر از هر چیز به طرح بستگی دارد. اگر آیتمها مبهم یا فیلدها قابلتأیید نباشند، بررسی عمیق هم چیزی جز حدس تولید نمیکند. این چند اصل را رعایت کنید:
- آیتمها را مشخص و متمایز بگیرید. «۱۵ شرکت فعال در یک حوزه» بهتر از «شرکتهای خوب» است. معیار ورود به فهرست باید طوری باشد که شخص دیگری هم بتواند همان فهرست را بسازد.
- فیلدها را ثابت و قابلتأیید کنید. «لایسنس»، «آخرین بهروزرسانی» و «لینک منبع» فیلد خوبیاند. فیلد مبهمی مثل «کیفیت» نتیجهٔ سلیقهای میدهد.
- با تعداد کم شروع کنید. پنج آیتم را امتحان کنید، کیفیت و هزینه را ببینید و بعد با
/research-add-itemsگسترش دهید. - فیلد «تاریخ بررسی» اضافه کنید تا گزارش بعداً قابل اعتماد بماند و بدانید کهنه شده یا نه.
- فیلد «منبع» را اجباری کنید. اگر قرار است گزارش به دیگران برسد، هر عدد باید لینکی داشته باشد.
| طرح ضعیف | طرح بهتر |
|---|---|
| آیتم: «بهترین ابزارهای تحقیق» | آیتم: «ابزارهای متنباز تحقیق که در یک ریپوی عمومی مستند دارند» |
| فیلد: «کیفیت» | فیلدها: «لایسنس»، «زبانهای پشتیبانیشده»، «آخرین بهروزرسانی» |
| بدون فیلد منبع | فیلد «لینک منبع» و «تاریخ بررسی» برای هر ردیف |
| ۵۰ آیتم از همان اول | ۵ آیتم برای آزمایش، بعد گسترش |
گزارش را چطور اعتبارسنجی کنیم؟
گزارش report.md را مثل پیشنویس یک همکار تازهکار بخوانید، نه مثل نتیجهٔ قطعی. کاری که ارزش دارد این است:
- لینک چند ردیف را تصادفی باز کنید و ببینید مطلب واقعاً همان چیزی است که گزارش گفته.
- عددهای حیاتی (قیمت، تاریخ، تعداد) را از منبع اصلی تأیید کنید.
- مقدارهای بیمنبع را حذف کنید یا به «نامشخص» تبدیل کنید. «نامشخص» از یک حدس مطمئن بهتر است.
- اگر گزارش قرار است منتشر شود، نام تهیهکننده و تاریخ بررسی را رویش بنویسید.
چکلیست کاملتر این کار در راهنمای تحقیق عمیق آمده است. یک قاعدهٔ ساده: هرچه گزارش قرار است تصمیم گرانتری را پشتیبانی کند، سهم بازبینی انسانی باید بیشتر باشد.
هزینه، عیبیابی و جای research skill در مجموعه
هزینه و مصرف توکن: چه انتظاری داشته باشیم؟
بررسی عمیق چند عامل موازی راه میاندازد و هر عامل جستوجو و خواندن صفحه انجام میدهد؛ پس مصرف توکن بهمراتب بالاتر از یک پرسش ساده است. چند کار برای کنترل آن:
- با تعداد کم آیتم شروع کنید و فیلدهای غیرضروری را حذف کنید؛ هر فیلد اضافه یعنی جستوجوی بیشتر برای هر آیتم.
- پیش از
/research-deepطرح را کامل بخوانید؛ اصلاح طرح رایگانترین مرحلهٔ کار است. - برای راههای کلیتر کاهش مصرف، راهنمای کاهش مصرف توکن Claude Code را ببینید.
عدد دقیق مصرف را نمیتوان از روی README پیشبینی کرد، چون به موضوع، تعداد آیتم و ابزار جستوجو بستگی دارد. بهتر است اولین اجرا را کوچک بگیرید و خودتان اندازه بگیرید.
عیبیابی رایج هنگام نصب و اجرا
این موارد از خود README و منطق نصب نتیجه میشوند و تجربهٔ شخصی جدید نیستند:
- دستور
/researchشناخته نمیشود. اول نسخهٔ Claude Code را چک کنید (۲٫۱٫۰ یا بالاتر). در نسخهٔ قدیمیتر بهجای آنrun /researchبنویسید. بعد مطمئن شوید پوشههای skill واقعاً در~/.claude/skillsهستند. - بررسی عمیق جستوجو نمیکند یا به عامل نمیرسد. README عامل جستوجو و ماژولهایش را «لازم» میداند. بررسی کنید فایل
web-search-agent.mdو پوشهٔweb-search-modulesدر~/.claude/agentsکپی شده باشند. - خطای وابستگی پایتون. اگر از نبود ماژول YAML شکایت شد،
pip install pyyamlرا با همان پایتونی اجرا کنید که ابزار از آن استفاده میکند. - گزارش فارسی یا ایرانی ضعیف است. کیفیت جستوجو به ابزار وب بستگی دارد و برای موضوعهای فارسی پوشش معمولاً کمتر است؛ منابع را دستی تکمیل کنید.
اگر Codex یا OpenCode دارید
README برای هر دو مراحل نصب جدا دارد. برای OpenCode، علاوه بر کپی skillها، باید متغیر OPENCODE_ENABLE_EXA=1 را برای فعالشدن جستوجوی وب تنظیم کنید و README تأکید میکند که بدون آن فقط web fetch دارید که برای مرحلهٔ بررسی عمیق ضعیفتر است. برای Codex هم skillهای مخصوص Codex، عامل web-researcher و ویرایش ~/.codex/config.toml لازم است و README یک اسکریپت نصب هم برای این کار دارد. چون این مقاله دربارهٔ Claude Code است، برای جزئیات این دو مسیر به خود README مراجعه کنید.
جای research skill در کل مجموعه
این ابزار یک حلقه از زنجیرهٔ بزرگتر است. اگر دنبال نقشهٔ کامل Claude Code هستید، راهنمای کامل Claude Code همهٔ ابزارها را کنار هم میگذارد. برای کار روزمرهٔ برنامهنویسی هم گردشکار توسعه با Claude Code نشان میدهد تحقیق، برنامهریزی و پیادهسازی را چطور پشت هم بچینید. اگر تحقیق شما دربارهٔ انتخاب ابزار برای یک پروژه است، همین دو مقاله کنار این ابزار خوب جواب میدهند.
جمعبندی
research skill Claude Code بهدرد تحقیقهایی میخورد که چندین مورد و چند ویژگی ثابت دارند: مقایسهٔ ابزارها، تحلیل رقبا یا مرور یک حوزه. ارزش اصلیاش توقف بین دو مرحله است؛ طرح را میخوانید و اصلاح میکنید، بعد بررسی گران را شروع میکنید. ابزار کوچک و جوان است، پس کدش را بخوانید، با پنج آیتم شروع کنید و خروجی را مثل پیشنویس بازبینی کنید.
کلید API برای Claude Code با پلن پرو
کلید API فقط با پلن پرو نقطه باز میشود؛ با همان یک کلید به Sonnet و Opus میرسید، ریالی پرداخت میکنید و مصرف هر درخواست را زنده در داشبورد میبینید.
این مقاله چگونه بررسی شد؟
دستورهای نصب و ویژگیها از README رسمی ابزار (و برای مفاهیم Claude Code از مستندات code.claude.com) برداشته شد و در ۱۳ آبان ۱۴۰۵ (۴ نوامبر ۲۰۲۶) دوباره با نسخهٔ فعلی ریپو مقایسه شد. ستاره، لایسنس و تاریخ آخرین بهروزرسانی از API گیتهاب همان روز آمده است. اگر دستوری در نسخهٔ شما فرق داشت، README همان نسخه معتبرتر است.
← تحقیق عمیق با هوش مصنوعی در Claude Code · آموزش Claude Code
منابع: README رسمی Weizhena/Deep-Research-skills؛ مستندات skillها در Claude Code؛ مستندات عاملهای فرعی. تاریخ بررسی: ۱۳ آبان ۱۴۰۵ (۴ نوامبر ۲۰۲۶).